
特色函数
特色函数
1. 降采样函数
1.1 date_bin 函数
1.1.1 功能描述
date_bin 是一个标量函数,用于将时间戳规整到指定的时间区间起点,并结合 GROUP BY 子句实现降采样。
- 部分区间结果为空:只会对满足条件的数据进行时间戳规整,不会填充缺失的时间区间。
- 全部区间结果为空::满足条件的整个查询范围内没有数据时,降采样返回空结果集
1.1.2 使用示例
示例数据
在示例数据页面中,包含了用于构建表结构和插入数据的SQL语句,下载并在IoTDB CLI中执行这些语句,即可将数据导入IoTDB,您可以使用这些数据来测试和执行示例中的SQL语句,并获得相应的结果。
示例 1:获取设备** 100 **某个时间范围的每小时平均温度
SELECT date_bin(1h, time) AS hour_time, avg(temperature) AS avg_temp
FROM table1
WHERE (time >= 2024-11-27 00:00:00  AND time <= 2024-11-30 00:00:00)
      AND device_id = '100'
GROUP BY 1;
结果:
+-----------------------------+--------+
|                    hour_time|avg_temp|
+-----------------------------+--------+
|2024-11-29T11:00:00.000+08:00|    null|
|2024-11-29T18:00:00.000+08:00|    90.0|
|2024-11-28T08:00:00.000+08:00|    85.0|
|2024-11-28T09:00:00.000+08:00|    null|
|2024-11-28T10:00:00.000+08:00|    85.0|
|2024-11-28T11:00:00.000+08:00|    88.0|
+-----------------------------+--------+
示例 2:获取每个设备某个时间范围的每小时平均温度
SELECT date_bin(1h, time) AS hour_time, device_id, avg(temperature) AS avg_temp
FROM table1
WHERE time >= 2024-11-27 00:00:00  AND time <= 2024-11-30 00:00:00
GROUP BY 1, device_id;
结果:
+-----------------------------+---------+--------+
|                    hour_time|device_id|avg_temp|
+-----------------------------+---------+--------+
|2024-11-29T11:00:00.000+08:00|      100|    null|
|2024-11-29T18:00:00.000+08:00|      100|    90.0|
|2024-11-28T08:00:00.000+08:00|      100|    85.0|
|2024-11-28T09:00:00.000+08:00|      100|    null|
|2024-11-28T10:00:00.000+08:00|      100|    85.0|
|2024-11-28T11:00:00.000+08:00|      100|    88.0|
|2024-11-29T10:00:00.000+08:00|      101|    85.0|
|2024-11-27T16:00:00.000+08:00|      101|    85.0|
+-----------------------------+---------+--------+
示例 3:获取所有设备某个时间范围的每小时平均温度
SELECT date_bin(1h, time) AS hour_time, avg(temperature) AS avg_temp
  FROM table1
  WHERE time >= 2024-11-27 00:00:00  AND time <= 2024-11-30 00:00:00
  group by 1;
结果:
+-----------------------------+--------+
|                    hour_time|avg_temp|
+-----------------------------+--------+
|2024-11-29T10:00:00.000+08:00|    85.0|
|2024-11-27T16:00:00.000+08:00|    85.0|
|2024-11-29T11:00:00.000+08:00|    null|
|2024-11-29T18:00:00.000+08:00|    90.0|
|2024-11-28T08:00:00.000+08:00|    85.0|
|2024-11-28T09:00:00.000+08:00|    null|
|2024-11-28T10:00:00.000+08:00|    85.0|
|2024-11-28T11:00:00.000+08:00|    88.0|
+-----------------------------+--------+
1.2 date_bin_gapfill 函数
1.2.1 功能描述
date_bin_gapfill 是 date_bin 的扩展,能够填充缺失的时间区间,从而返回完整的时间序列。
- 部分区间结果为空:对满足条件的数据进行时间戳规整,并填充缺失的时间区间。
- 全部区间结果为空::整个查询范围内没有数据时,
date_bin_gapfill会返回空结果集
1.2.2 功能限制
date_bin_gapfill必须与GROUP BY子句搭配使用,如果用在其他子句中,不会报错,但不会执行 gapfill 功能,效果与使用date_bin相同。- 每个
GROUP BY子句中只能使用一个date_bin_gapfill。如果出现多个date_bin_gapfill,会报错:multiple date_bin_gapfill calls not allowed date_bin_gapfill的执行顺序:GAPFILL 功能发生在HAVING子句执行之后,FILL子句执行之前。- 使用
date_bin_gapfill时,****WHERE子句中的时间过滤条件必须是以下形式之一:time >= XXX AND time <= XXXtime > XXX AND time < XXXtime BETWEEN XXX AND XXX
- 使用
date_bin_gapfill时,如果出现其他时间过滤条件,会报错。时间过滤条件与其他值过滤条件只能通过AND连接。 - 如果不能从 where 子句中推断出 startTime 和 endTime,则报错:could not infer startTime or endTime from WHERE clause。
1.2.3 使用示例
示例 1:填充缺失时间区间
SELECT date_bin_gapfill(1h, time) AS hour_time, avg(temperature) AS avg_temp
FROM table1
WHERE (time >= 2024-11-28 07:00:00  AND time <= 2024-11-28 16:00:00)
      AND device_id = '100'
GROUP BY 1;
结果:
+-----------------------------+--------+
|                    hour_time|avg_temp|
+-----------------------------+--------+
|2024-11-28T07:00:00.000+08:00|    null|
|2024-11-28T08:00:00.000+08:00|    85.0|
|2024-11-28T09:00:00.000+08:00|    null|
|2024-11-28T10:00:00.000+08:00|    85.0|
|2024-11-28T11:00:00.000+08:00|    88.0|
|2024-11-28T12:00:00.000+08:00|    null|
|2024-11-28T13:00:00.000+08:00|    null|
|2024-11-28T14:00:00.000+08:00|    null|
|2024-11-28T15:00:00.000+08:00|    null|
|2024-11-28T16:00:00.000+08:00|    null|
+-----------------------------+--------+
示例 2:结合设备分组填充缺失时间区间
SELECT date_bin_gapfill(1h, time) AS hour_time, device_id, avg(temperature) AS avg_temp
FROM table1
WHERE time >= 2024-11-28 07:00:00  AND time <= 2024-11-28 16:00:00
GROUP BY 1, device_id;
结果:
+-----------------------------+---------+--------+
|                    hour_time|device_id|avg_temp|
+-----------------------------+---------+--------+
|2024-11-28T07:00:00.000+08:00|      100|    null|
|2024-11-28T08:00:00.000+08:00|      100|    85.0|
|2024-11-28T09:00:00.000+08:00|      100|    null|
|2024-11-28T10:00:00.000+08:00|      100|    85.0|
|2024-11-28T11:00:00.000+08:00|      100|    88.0|
|2024-11-28T12:00:00.000+08:00|      100|    null|
|2024-11-28T13:00:00.000+08:00|      100|    null|
|2024-11-28T14:00:00.000+08:00|      100|    null|
|2024-11-28T15:00:00.000+08:00|      100|    null|
|2024-11-28T16:00:00.000+08:00|      100|    null|
+-----------------------------+---------+--------+
示例 3:查询范围内没有数据返回空结果集
SELECT date_bin_gapfill(1h, time) AS hour_time, device_id, avg(temperature) AS avg_temp
FROM table1
WHERE time >= 2024-11-27 09:00:00  AND time <= 2024-11-27 14:00:00
GROUP BY 1, device_id;
结果:
+---------+---------+--------+
|hour_time|device_id|avg_temp|
+---------+---------+--------+
+---------+---------+--------+
1.3 M4 函数
1.3.1 功能描述
M4 是表模型内置的多态表值函数,用于对时序数据进行降采样。函数在每个窗口内提取首点(First)、尾点(Last)、最小值点(Bottom)和最大值点(Top),在减少返回数据量的同时尽量保持趋势图形状。与标量函数或聚合函数不同,M4 接收一个表参数并返回结果表,必须在 FROM 子句中调用。
首点:窗口内时间戳最小且值不为
NULL的点。尾点:窗口内时间戳最大且值不为
NULL的点。最小值点和最大值点:窗口内值最小或最大的点;值相同时保留按输入扫描顺序遇到的第一个点。
支持时间窗口和点数窗口两种模式。
SIZE使用时间长度字面量(例如1h、10m)时为时间窗口;使用正整数(例如100)时为点数窗口。
V2.0.12.1 版本起支持
1.3.2 函数定义
SELECT *
FROM M4(
  DATA => input_table PARTITION BY partition_column ORDER BY time_column,
  TIMECOL => 'time_column',
  [ORIGIN => origin_timestamp,]
  SIZE => window_duration | window_point_count,
  [SLIDE => window_duration | window_point_count]
);
DATA 是集合语义表参数。使用时必须指定 ORDER BY,且排序列只能是 TIMECOL 指定的时间列并按升序排列;PARTITION BY 可选,不指定时整张输入表作为一个分区处理。参数可按名称或按声明顺序传递,建议使用命名参数。
1.3.3 参数说明
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
DATA | 表参数(SET SEMANTIC) | 是 | 输入表或子查询。可指定 PARTITION BY 和 ORDER BY。 |
TIMECOL | 字符串 | 是 | 时间列名。该列必须为 TIMESTAMP 类型,且 ORDER BY 只能包含该列。 |
ORIGIN | 时间戳 | 否 | 时间窗口的对齐原点,默认值为 0。点数窗口模式不使用该参数。 |
SIZE | 时间长度或 INT64 | 是 | 时间窗口的窗口长度,或点数窗口的点数大小;必须为正数。 |
SLIDE | 与 SIZE 同类型 | 否 | 窗口滑动步长,默认与 SIZE 相同。必须与 SIZE 使用相同窗口模式。 |
计算规则
TIMECOL指定列不参与 M4 计算。PARTITION BY指定列不参与计算,但保留在输出结果中。除上述列外,所有可比较类型列均参与 M4 计算。
排除上述列后,若无可比较类型列,或存在不可比较类型列,分析阶段直接报错。
参与列值为
NULL的记录,不参与该列的first、last、bottom、top计算。各参与列先计算并去重
first、last、bottom、top特征点,再按时间戳升序输出。
返回结果
时间窗口模式:固定生成
window_start、window_end(时间戳类型),表示窗口范围[window_start, window_end)。点数窗口模式:固定生成
window_index(长整数类型),表示窗口序号;在每个PARTITION BY分区内独立计算,从0开始递增。PARTITION BY 列:按原列名、原类型保留输出,多个列按声明顺序排列。
OBJECT类型不支持作为分区列;BLOB类型可保留输出,但不参与 M4 计算。动态生成列:每个参与 M4 计算的列
c生成c_time(特征点时间戳)和c(特征点值)两列,类型与输入列保持一致。多列结果按输入列顺序展开。
补充说明:窗口输出行数取所有参与列特征点数量的最大值。特征点较少的列,其剩余行的 c_time 和 c 填充 NULL。
1.3.4 使用示例
以下示例均使用示例数据中的 table1。由于 table1 中除时间列和分区列外还包含其他字段,因此示例通过子查询仅选择 time、device_id、temperature 和 humidity 参与 M4 计算。
- 示例 1:时间窗口模式
以 device_id = '101' 的数据为例,每 3 分钟划分一个窗口。SIZE => 3m 表示使用时间窗口模式,窗口长度为 3 分钟。窗口采用半开区间 [window_start, window_end),每个窗口分别提取 temperature 和 humidity 列的首点、尾点、最小值点和最大值点,并按照特征点时间戳升序输出。
SELECT window_start,
       window_end,
       device_id,
       temperature_time,
       temperature,
       humidity_time,
       humidity
FROM M4(
  DATA => (
    SELECT time, device_id, temperature, humidity
    FROM table1
    WHERE device_id = '101'
      AND time >= 2024-11-27 16:38:00
      AND time <= 2024-11-27 16:44:00
  ) PARTITION BY device_id ORDER BY time,
  TIMECOL => 'time',
  SIZE => 3m
);
结果:
+-----------------------------+-----------------------------+---------+-----------------------------+-----------+-----------------------------+--------+
|                 window_start|                   window_end|device_id|             temperature_time|temperature|                humidity_time|humidity|
+-----------------------------+-----------------------------+---------+-----------------------------+-----------+-----------------------------+--------+
|2024-11-27T16:36:00.000+08:00|2024-11-27T16:39:00.000+08:00|      101|                         null|       null|2024-11-27T16:38:00.000+08:00|    35.1|
|2024-11-27T16:39:00.000+08:00|2024-11-27T16:42:00.000+08:00|      101|2024-11-27T16:39:00.000+08:00|       85.0|2024-11-27T16:39:00.000+08:00|    35.3|
|2024-11-27T16:39:00.000+08:00|2024-11-27T16:42:00.000+08:00|      101|2024-11-27T16:41:00.000+08:00|       85.0|                         null|    null|
|2024-11-27T16:42:00.000+08:00|2024-11-27T16:45:00.000+08:00|      101|                         null|       null|2024-11-27T16:42:00.000+08:00|    35.2|
+-----------------------------+-----------------------------+---------+-----------------------------+-----------+-----------------------------+--------+- 示例 2:点数窗口模式
以 device_id = '101' 的数据为例,每 3 个数据点划分一个窗口。SIZE => 3 表示使用点数窗口模式,每 3 行数据划分一个窗口。窗口序号通过 window_index 标识,并在每个分区内从 0 开始计算。
SELECT window_index,
       device_id,
       temperature_time,
       temperature,
       humidity_time,
       humidity
FROM M4(
  DATA => (
    SELECT time, device_id, temperature, humidity
    FROM table1
    WHERE device_id = '101'
      AND time >= 2024-11-27 16:38:00
      AND time <= 2024-11-27 16:44:00
  ) PARTITION BY device_id ORDER BY time,
  TIMECOL => 'time',
  SIZE => 3
);
结果:
+------------+---------+-----------------------------+-----------+-----------------------------+--------+
|window_index|device_id|             temperature_time|temperature|                humidity_time|humidity|
+------------+---------+-----------------------------+-----------+-----------------------------+--------+
|           0|      101|2024-11-27T16:39:00.000+08:00|       85.0|2024-11-27T16:38:00.000+08:00|    35.1|
|           0|      101|2024-11-27T16:40:00.000+08:00|       85.0|2024-11-27T16:39:00.000+08:00|    35.3|
|           1|      101|2024-11-27T16:41:00.000+08:00|       85.0|2024-11-27T16:42:00.000+08:00|    35.2|
+------------+---------+-----------------------------+-----------+-----------------------------+--------+
如果需要设置窗口滑动步长,可以同时指定 SLIDE:
SELECT window_index,
       device_id,
       temperature_time,
       temperature,
       humidity_time,
       humidity
FROM M4(
  DATA => (
    SELECT time, device_id, temperature, humidity
    FROM table1
    WHERE device_id = '101'
      AND time >= 2024-11-27 16:38:00
      AND time <= 2024-11-27 16:44:00
  ) PARTITION BY device_id ORDER BY time,
  TIMECOL => 'time',
  SIZE => 3,
  SLIDE => 2
);
上述调用表示窗口大小为 3 个数据点,窗口每次向后滑动 2 个数据点。
结果:
+------------+---------+-----------------------------+-----------+-----------------------------+--------+
|window_index|device_id|             temperature_time|temperature|                humidity_time|humidity|
+------------+---------+-----------------------------+-----------+-----------------------------+--------+
|           0|      101|2024-11-27T16:39:00.000+08:00|       85.0|2024-11-27T16:38:00.000+08:00|    35.1|
|           0|      101|2024-11-27T16:40:00.000+08:00|       85.0|2024-11-27T16:39:00.000+08:00|    35.3|
|           1|      101|2024-11-27T16:40:00.000+08:00|       85.0|2024-11-27T16:42:00.000+08:00|    35.2|
|           1|      101|2024-11-27T16:41:00.000+08:00|       85.0|                         null|    null|
|           2|      101|                         null|       null|2024-11-27T16:42:00.000+08:00|    35.2|
+------------+---------+-----------------------------+-----------+-----------------------------+--------+- 示例 3:非法示例——
ORDER BY未指定时间列
M4 要求 DATA 参数必须指定 ORDER BY,且排序列必须与 TIMECOL 参数指定的时间列一致。下面的示例错误地使用 temperature 作为排序列:
SELECT *
FROM M4(
  DATA => (
    SELECT time, device_id, temperature, humidity
    FROM table1
    WHERE device_id = '101'
  ) PARTITION BY device_id ORDER BY temperature,
  TIMECOL => 'time',
  SIZE => 3m
);
报错:
Msg: org.apache.iotdb.jdbc.IoTDBSQLException: 701: The ORDER BY clause of the DATA argument must contain exactly the time column specified by the TIMECOL argument.2. DIFF函数
2.1 功能概述
DIFF 函数用于计算当前行与上一行的差值。对于第一行,由于没有前一行数据,因此永远返回 NULL。
2.2 函数定义
DIFF(numberic[, boolean]) -> Double2.3 参数说明
第一个参数:数值类型
- 类型:必须是数值类型(
INT32、INT64、FLOAT、DOUBLE) - 作用:指定要计算差值的列。
- 类型:必须是数值类型(
第二个参数:布尔类型(可选)
- 类型:布尔类型(
true或false)。 - 默认值:
true。 - 作用:
true:忽略NULL值,向前找到第一个非NULL值进行差值计算。如果前面没有非NULL值,则返回NULL。false:不忽略NULL值,如果前一行为NULL,则差值结果为NULL。
- 类型:布尔类型(
2.4 注意事项
- 在树模型中,第二个参数需要指定为
'ignoreNull'='true'或'ignoreNull'='false',但在表模型中,只需指定为true或false。 - 如果用户写成
'ignoreNull'='true'或'ignoreNull'='false',表模型会将其视为对两个字符串常量进行等号比较,返回布尔值,但结果总是false,等价于指定第二个参数为false。
2.5 使用示例
示例 1:忽略 NULL 值
SELECT time, DIFF(temperature) AS diff_temp
FROM table1
WHERE device_id = '100';
结果:
+-----------------------------+---------+
|                         time|diff_temp|
+-----------------------------+---------+
|2024-11-29T11:00:00.000+08:00|     null|
|2024-11-29T18:30:00.000+08:00|     null|
|2024-11-28T08:00:00.000+08:00|     -5.0|
|2024-11-28T09:00:00.000+08:00|     null|
|2024-11-28T10:00:00.000+08:00|      0.0|
|2024-11-28T11:00:00.000+08:00|      3.0|
|2024-11-26T13:37:00.000+08:00|      2.0|
|2024-11-26T13:38:00.000+08:00|      0.0|
+-----------------------------+---------+
示例 2:不忽略 NULL 值
SELECT time, DIFF(temperature, false) AS diff_temp
FROM table1
WHERE device_id = '100';
结果:
+-----------------------------+---------+
|                         time|diff_temp|
+-----------------------------+---------+
|2024-11-29T11:00:00.000+08:00|     null|
|2024-11-29T18:30:00.000+08:00|     null|
|2024-11-28T08:00:00.000+08:00|     -5.0|
|2024-11-28T09:00:00.000+08:00|     null|
|2024-11-28T10:00:00.000+08:00|     null|
|2024-11-28T11:00:00.000+08:00|      3.0|
|2024-11-26T13:37:00.000+08:00|      2.0|
|2024-11-26T13:38:00.000+08:00|      0.0|
+-----------------------------+---------+
示例 3:完整示例
SELECT time, temperature,
       DIFF(temperature) AS diff_temp_1,
       DIFF(temperature, false) AS diff_temp_2
FROM table1
WHERE device_id = '100';
结果:
+-----------------------------+-----------+-----------+-----------+
|                         time|temperature|diff_temp_1|diff_temp_2|
+-----------------------------+-----------+-----------+-----------+
|2024-11-29T11:00:00.000+08:00|       null|       null|       null|
|2024-11-29T18:30:00.000+08:00|       90.0|       null|       null|
|2024-11-28T08:00:00.000+08:00|       85.0|       -5.0|       -5.0|
|2024-11-28T09:00:00.000+08:00|       null|       null|       null|
|2024-11-28T10:00:00.000+08:00|       85.0|        0.0|       null|
|2024-11-28T11:00:00.000+08:00|       88.0|        3.0|        3.0|
|2024-11-26T13:37:00.000+08:00|       90.0|        2.0|        2.0|
|2024-11-26T13:38:00.000+08:00|       90.0|        0.0|        0.0|
+-----------------------------+-----------+-----------+-----------+
3. 时序分窗函数
原始示例数据如下:
IoTDB> SELECT * FROM bid;
+-----------------------------+--------+-----+
|                         time|stock_id|price|
+-----------------------------+--------+-----+
|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
+-----------------------------+--------+-----+

-- 创建语句
CREATE TABLE bid(time TIMESTAMP TIME, stock_id STRING TAG, price FLOAT FIELD);
-- 插入数据
INSERT INTO bid(time, stock_id, price) VALUES('2021-01-01T09:05:00','AAPL',100.0),('2021-01-01T09:06:00','TESL',200.0),('2021-01-01T09:07:00','AAPL',103.0),('2021-01-01T09:07:00','TESL',202.0),('2021-01-01T09:09:00','AAPL',102.0),('2021-01-01T09:15:00','TESL',195.0);
3.1 HOP
3.1.1 功能描述
HOP 函数用于按时间分段分窗分析,识别每一行数据所属的时间窗口。该函数通过指定固定窗口大小(size)和窗口滑动步长(SLIDE),将数据按时间戳分配到所有与其时间戳重叠的窗口中。若窗口之间存在重叠(步长 < 窗口大小),数据会自动复制到多个窗口。
3.1.2 函数定义
HOP(data, timecol, size, slide[, origin])3.1.3 参数说明
| 参数名 | 参数类型 | 参数属性 | 描述 |
|---|---|---|---|
| DATA | 表参数 | ROW SEMANTICPASS THROUGH | 输入表 |
| TIMECOL | 标量参数 | 字符串类型默认值:time | 时间列 |
| SIZE | 标量参数 | 长整数类型 | 窗口大小 |
| SLIDE | 标量参数 | 长整数类型 | 窗口滑动步长 |
| ORIGIN | 标量参数 | 时间戳类型默认值:Unix 纪元时间 | 第一个窗口起始时间 |
3.1.4 返回结果
HOP 函数的返回结果列包含:
- window_start: 窗口开始时间(闭区间)
- window_end: 窗口结束时间(开区间)
- 映射列:DATA 参数的所有输入列
3.1.5 使用示例
IoTDB> SELECT * FROM HOP(DATA => bid,TIMECOL => 'time',SLIDE => 5m,SIZE => 10m);
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|                 window_start|                   window_end|                         time|stock_id|price|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:25:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY TIME
IoTDB> SELECT window_start, window_end, stock_id, avg(price) as avg FROM HOP(DATA => bid,TIMECOL => 'time',SLIDE => 5m,SIZE => 10m) GROUP BY window_start, window_end, stock_id;
+-----------------------------+-----------------------------+--------+------------------+
|                 window_start|                   window_end|stock_id|               avg|
+-----------------------------+-----------------------------+--------+------------------+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:25:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    AAPL|101.66666666666667|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:15:00.000+08:00|    AAPL|101.66666666666667|
+-----------------------------+-----------------------------+--------+------------------+
3.2 SESSION
3.2.1 功能描述
SESSION 函数用于按会话间隔对数据进行分窗。系统逐行检查与前一行的时间间隔,小于阈值(GAP)则归入当前窗口,超过则归入下一个窗口。
3.2.2 函数定义
SESSION(data [PARTITION BY(pkeys, ...)] [ORDER BY(okeys, ...)], timecol, gap)3.2.3 参数说明
| 参数名 | 参数类型 | 参数属性 | 描述 |
|---|---|---|---|
| DATA | 表参数 | SET SEMANTICPASS THROUGH | 输入表通过 pkeys、okeys 指定分区和排序 |
| TIMECOL | 标量参数 | 字符串类型默认值:'time' | 时间列名 |
| GAP | 标量参数 | 长整数类型 | 会话间隔阈值 |
3.2.4 返回结果
SESSION 函数的返回结果列包含:
- window_start: 会话窗口内的第一条数据的时间
- window_end: 会话窗口内的最后一条数据的时间
- 映射列:DATA 参数的所有输入列
3.2.5 使用示例
IoTDB> SELECT * FROM SESSION(DATA => bid PARTITION BY stock_id ORDER BY time,TIMECOL => 'time',GAP => 2m);
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|                 window_start|                   window_end|                         time|stock_id|price|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:06:00.000+08:00|2021-01-01T09:07:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:06:00.000+08:00|2021-01-01T09:07:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:15:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:09:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:09:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:09:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY SESSION
IoTDB> SELECT window_start, window_end, stock_id, avg(price) as avg FROM SESSION(DATA => bid PARTITION BY stock_id ORDER BY time,TIMECOL => 'time',GAP => 2m) GROUP BY window_start, window_end, stock_id;
+-----------------------------+-----------------------------+--------+------------------+
|                 window_start|                   window_end|stock_id|               avg|
+-----------------------------+-----------------------------+--------+------------------+
|2021-01-01T09:06:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|101.66666666666667|
+-----------------------------+-----------------------------+--------+------------------+
3.3 VARIATION
3.3.1 功能描述
VARIATION 函数用于按数据差值分窗,将第一条数据作为首个窗口的基准值,每个数据点会与基准值进行差值运算,如果差值小于给定的阈值(delta)则加入当前窗口;如果超过阈值,则分为下一个窗口,将该值作为下一个窗口的基准值。
3.3.2 函数定义
VARIATION(data [PARTITION BY(pkeys, ...)] [ORDER BY(okeys, ...)], col, delta)3.3.3 参数说明
| 参数名 | 参数类型 | 参数属性 | 描述 |
|---|---|---|---|
| DATA | 表参数 | SET SEMANTICPASS THROUGH | 输入表通过 pkeys、okeys 指定分区和排序 |
| COL | 标量参数 | 字符串类型 | 标识对哪一列计算差值 |
| DELTA | 标量参数 | 浮点数类型 | 差值阈值 |
3.3.4 返回结果
VARIATION 函数的返回结果列包含:
- window_index: 窗口编号
- 映射列:DATA 参数的所有输入列
3.3.5 使用示例
IoTDB> SELECT * FROM VARIATION(DATA => bid PARTITION BY stock_id ORDER BY time,COL => 'price',DELTA => 2.0);
+------------+-----------------------------+--------+-----+
|window_index|                         time|stock_id|price|
+------------+-----------------------------+--------+-----+
|           0|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|           0|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|           1|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|           0|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|           1|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|           1|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY VARIATION
IoTDB> SELECT first(time) as window_start, last(time) as window_end, stock_id, avg(price) as avg FROM VARIATION(DATA => bid PARTITION BY stock_id ORDER BY time,COL => 'price', DELTA => 2.0) GROUP BY window_index, stock_id;
+-----------------------------+-----------------------------+--------+-----+
|                 window_start|                   window_end|stock_id|  avg|
+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:06:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|201.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:07:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.5|
+-----------------------------+-----------------------------+--------+-----+
3.4 CAPACITY
3.4.1 功能描述
CAPACITY 函数用于按数据点数(行数)分窗,每个窗口最多有 SIZE 行数据。自 V2.0.12.1 起支持通过参数 SLIDE 指定相邻窗口起点之间间隔的行数。
3.4.2 函数定义
CAPACITY(
  DATA => <table_or_query>
    [PARTITION BY <partition_expression> [, ...]]
    [ORDER BY <sort_item> [, ...]],
  SIZE => <positive_int64>
  [, SLIDE => <positive_int64>]
)
3.4.3 参数说明
| 参数 | 类型 | 是否必填 | 说明 |
|---|---|---|---|
| DATA | Table | 是 | 输入表或子查询,支持 PARTITION BY 和 ORDER BY,透传输入列。 |
| SIZE | INT64 Scalar | 是 | 窗口容量,必须为正数,表示单个窗口最多覆盖的行数。 |
| SLIDE | INT64 Scalar | 否 | 窗口滑动步长,显式传入时必须为正数;省略时默认等于 SIZE。 |
指定 PARTITION BY 时,每个分区独立从 0 开始计算行号和窗口编号;
指定 ORDER BY 时,按排序结果确定行号顺序。
窗口编号从 0 开始,第 k 个窗口覆盖的行号范围为
[k * SLIDE, k * SLIDE + SIZE)。不同参数关系对应的窗口行为如下:
| 参数关系 | 窗口类型 | 行为 |
|---|---|---|
SLIDE < SIZE | 重叠窗口 | 相邻窗口有重叠,同一输入行可能属于多个窗口,并以不同的 window_index 输出多行。 |
SLIDE = SIZE | 非重叠窗口 | 相邻窗口首尾相接,行为与历史版本的 CAPACITY(DATA => ..., SIZE => n) 一致。 |
SLIDE > SIZE | 间隔窗口 | 相邻窗口之间存在空档,落在空档内的输入行不输出。 |
3.4.4 返回结果
CAPACITY 函数的返回结果列包含:
window_index: 窗口编号,为 INT64 类型,从 0 开始。
DATA 参数透传列:保持输入表对应列的名称和类型。
返回结果可直接查询,也可继续基于 window_index 和业务分组列进行聚合。
3.4.5 使用示例
IoTDB> SELECT * FROM CAPACITY(DATA => bid PARTITION BY stock_id ORDER BY time, SIZE => 2);
+------------+-----------------------------+--------+-----+
|window_index|                         time|stock_id|price|
+------------+-----------------------------+--------+-----+
|           0|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|           0|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|           1|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|           0|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|           0|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|           1|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY COUNT
IoTDB> SELECT first(time) as start_time, last(time) as end_time, stock_id, avg(price) as avg FROM CAPACITY(DATA => bid PARTITION BY stock_id ORDER BY time, SIZE => 2) GROUP BY window_index, stock_id;
+-----------------------------+-----------------------------+--------+-----+
|                   start_time|                     end_time|stock_id|  avg|
+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:06:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|201.0|
|2021-01-01T09:15:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:05:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|101.5|
|2021-01-01T09:09:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+-----------------------------+-----------------------------+--------+-----+

-- 使用 SLIDE 参数生成重叠窗口(SLIDE < SIZE)
TimechoDB> SELECT * FROM CAPACITY(DATA => bid PARTITION BY stock_id ORDER BY time, SIZE => 2, SLIDE => 1);
+------------+-----------------------------+--------+-----+
|window_index|                         time|stock_id|price|
+------------+-----------------------------+--------+-----+
|           0|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|           0|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|           1|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|           1|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
|           2|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
|           0|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|           0|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|           1|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|           1|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|           2|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
+------------+-----------------------------+--------+-----+
3.5 TUMBLE
3.5.1 功能描述
TUMBLE 函数用于通过时间属性字段为每行数据分配一个窗口,滚动窗口的大小固定且不重复。
3.5.2 函数定义
TUMBLE(data, timecol, size[, origin])3.5.3 参数说明
| 参数名 | 参数类型 | 参数属性 | 描述 |
|---|---|---|---|
| DATA | 表参数 | ROW SEMANTICPASS THROUGH | 输入表 |
| TIMECOL | 标量参数 | 字符串类型默认值:time | 时间列 |
| SIZE | 标量参数 | 长整数类型 | 窗口大小,需为正数 |
| ORIGIN | 标量参数 | 时间戳类型默认值:Unix 纪元时间 | 第一个窗口起始时间 |
3.5.4 返回结果
TUBMLE 函数的返回结果列包含:
- window_start: 窗口开始时间(闭区间)
- window_end: 窗口结束时间(开区间)
- 映射列:DATA 参数的所有输入列
3.5.5 使用示例
IoTDB> SELECT * FROM TUMBLE( DATA => bid, TIMECOL => 'time', SIZE => 10m);
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|                 window_start|                   window_end|                         time|stock_id|price|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY TIME
IoTDB> SELECT window_start, window_end, stock_id, avg(price) as avg FROM TUMBLE(DATA => bid, TIMECOL => 'time', SIZE => 10m) GROUP BY window_start, window_end, stock_id;
+-----------------------------+-----------------------------+--------+------------------+
|                 window_start|                   window_end|stock_id|               avg|
+-----------------------------+-----------------------------+--------+------------------+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    AAPL|101.66666666666667|
+-----------------------------+-----------------------------+--------+------------------+
3.6 CUMULATE
3.6.1 功能描述
Cumulate 函数用于从初始的窗口开始,创建相同窗口开始但窗口结束步长不同的窗口,直到达到最大的窗口大小。每个窗口包含其区间内的元素。例如:1小时步长,24小时大小的累计窗口,每天可以获得如下这些窗口:[00:00, 01:00),[00:00, 02:00),[00:00, 03:00), …, [00:00, 24:00)
3.6.2 函数定义
CUMULATE(data, timecol, size, step[, origin])3.6.3 参数说明
| 参数名 | 参数类型 | 参数属性 | 描述 |
|---|---|---|---|
| DATA | 表参数 | ROW SEMANTICPASS THROUGH | 输入表 |
| TIMECOL | 标量参数 | 字符串类型默认值:time | 时间列 |
| SIZE | 标量参数 | 长整数类型 | 窗口大小,SIZE必须是STEP的整数倍,需为正数 |
| STEP | 标量参数 | 长整数类型 | 窗口步长,需为正数 |
| ORIGIN | 标量参数 | 时间戳类型默认值:Unix 纪元时间 | 第一个窗口起始时间 |
注意:size 如果不是 step 的整数倍,则会报错
Cumulative table function requires size must be an integral multiple of step
3.6.4 返回结果
CUMULATE函数的返回结果列包含:
- window_start: 窗口开始时间(闭区间)
- window_end: 窗口结束时间(开区间)
- 映射列:DATA 参数的所有输入列
3.6.5 使用示例
IoTDB> SELECT * FROM CUMULATE(DATA => bid,TIMECOL => 'time',STEP => 2m,SIZE => 10m);
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|                 window_start|                   window_end|                         time|stock_id|price|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:06:00.000+08:00|    TESL|200.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    TESL|202.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:16:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:18:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|2021-01-01T09:15:00.000+08:00|    TESL|195.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:06:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:05:00.000+08:00|    AAPL|100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:07:00.000+08:00|    AAPL|103.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|2021-01-01T09:09:00.000+08:00|    AAPL|102.0|
+-----------------------------+-----------------------------+-----------------------------+--------+-----+

-- 结合 GROUP BY 语句,等效于树模型的 GROUP BY TIME
IoTDB> SELECT window_start, window_end, stock_id, avg(price) as avg FROM CUMULATE(DATA => bid,TIMECOL => 'time',STEP => 2m, SIZE => 10m) GROUP BY window_start, window_end, stock_id;
+-----------------------------+-----------------------------+--------+------------------+
|                 window_start|                   window_end|stock_id|               avg|
+-----------------------------+-----------------------------+--------+------------------+
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    TESL|             201.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:16:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:18:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:10:00.000+08:00|2021-01-01T09:20:00.000+08:00|    TESL|             195.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:06:00.000+08:00|    AAPL|             100.0|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:08:00.000+08:00|    AAPL|             101.5|
|2021-01-01T09:00:00.000+08:00|2021-01-01T09:10:00.000+08:00|    AAPL|101.66666666666667|
+-----------------------------+-----------------------------+--------+------------------+
4. 窗口函数
4.1 语法定义
windowDefinition
    : name=identifier AS '(' windowSpecification ')'
    ;

windowSpecification
    : (existingWindowName=identifier)?
      (PARTITION BY partition+=expression (',' partition+=expression)*)?
      (ORDER BY sortItem (',' sortItem)*)?
      windowFrame?
    ;

windowFrame
    : frameExtent
    ;

frameExtent
    : frameType=RANGE start=frameBound
    | frameType=ROWS start=frameBound
    | frameType=GROUPS start=frameBound
    | frameType=RANGE BETWEEN start=frameBound AND end=frameBound
    | frameType=ROWS BETWEEN start=frameBound AND end=frameBound
    | frameType=GROUPS BETWEEN start=frameBound AND end=frameBound
    ;

frameBound
    : UNBOUNDED boundType=PRECEDING                 #unboundedFrame
    | UNBOUNDED boundType=FOLLOWING                 #unboundedFrame
    | CURRENT ROW                                   #currentRowBound
    | expression boundType=(PRECEDING | FOLLOWING)  #boundedFrame
;更多详细功能介绍请参考:窗口函数
4.2 使用示例
表 device_flow 原始数据如下
+-----------------------------+------+-----+
|                         time|device| flow|
+-----------------------------+------+-----+
|1970-01-01T08:00:00.000+08:00|    d0|    3|
|1970-01-01T08:00:00.001+08:00|    d0|    5|
|1970-01-01T08:00:00.002+08:00|    d0|    3|
|1970-01-01T08:00:00.003+08:00|    d0|    1|
|1970-01-01T08:00:00.004+08:00|    d1|    2|
|1970-01-01T08:00:00.005+08:00|    d1|    4|
+-----------------------------+------+-----+- 从 device_flow 中查询所有列,并按 device 维度分组,在每个设备分组内按 flow 字段值排序,计算 flow 字段的累计求和,最终将累计和命名为 sum 列返回。
查询语句:
IoTDB> SELECT *, sum(flow) OVER (PARTITION BY device ORDER BY flow) as sum FROM device_flow;查询结果:
+-----------------------------+------+----+----+
|                         time|device|flow| sum|
+-----------------------------+------+----+----+
|1970-01-01T08:00:04.000+08:00|    d1|   2| 2.0|
|1970-01-01T08:00:05.000+08:00|    d1|   4| 6.0|
|1970-01-01T08:00:03.000+08:00|    d0|   1| 1.0|
|1970-01-01T08:00:00.000+08:00|    d0|   3| 7.0|
|1970-01-01T08:00:02.000+08:00|    d0|   3| 7.0|
|1970-01-01T08:00:01.000+08:00|    d0|   5|12.0|
+-----------------------------+------+----+----+- 从 device_flow 表查询所有原始列,按 device 设备分组,每个设备分组内按 flow 字段值排序,统计「当前行所在的 flow 分组 + 前 1 个 flow 分组」范围内的行数(计数),最终将计数结果命名为 count 列返回。
查询语句:
IoTDB> SELECT *, count(flow) OVER(PARTITION BY device ORDER BY flow GROUPS BETWEEN 1 PRECEDING AND CURRENT ROW) as count FROM device_flow;查询结果:
+-----------------------------+------+----+-----+
|                         time|device|flow|count|
+-----------------------------+------+----+-----+
|1970-01-01T08:00:04.000+08:00|    d1|   2|    1|
|1970-01-01T08:00:05.000+08:00|    d1|   4|    2|
|1970-01-01T08:00:03.000+08:00|    d0|   1|    1|
|1970-01-01T08:00:00.000+08:00|    d0|   3|    3|
|1970-01-01T08:00:02.000+08:00|    d0|   3|    3|
|1970-01-01T08:00:01.000+08:00|    d0|   5|    3|
+-----------------------------+------+----+-----+- 从 device_flow 表查询所有原始列,按 device 分组,每个分组内按 flow 字段值升序排序,统计「当前行 flow 值 - 2」到「当前行 flow 值」这个数值区间内的所有行的数量,最终将计数结果命名为 count 列返回。
查询语句:
IoTDB> SELECT *,count(flow) OVER(PARTITION BY device ORDER BY flow RANGE BETWEEN 2 PRECEDING AND CURRENT ROW) as count FROM device_flow;查询结果:
+-----------------------------+------+----+-----+
|                         time|device|flow|count|
+-----------------------------+------+----+-----+
|1970-01-01T08:00:04.000+08:00|    d1|   2|    1|
|1970-01-01T08:00:05.000+08:00|    d1|   4|    2|
|1970-01-01T08:00:03.000+08:00|    d0|   1|    1|
|1970-01-01T08:00:00.000+08:00|    d0|   3|    3|
|1970-01-01T08:00:02.000+08:00|    d0|   3|    3|
|1970-01-01T08:00:01.000+08:00|    d0|   5|    3|
+-----------------------------+------+----+-----+
5. Object 类型读取函数
描述:用于读取 OBJECT 对象的二进制内容。返回 BLOB 类型(对象的二进制内容)。
V2.0.8 版本起支持
语法:
READ_OBJECT(object [, offset, length])参数:
- 必选参数:
object,类型为 OBJECT - 可选参数:
offset,类型为 long(int64),为读取的偏移量,缺省值为0。如果 offset 小于 0,或者大于等于全文件长度,则抛异常length,类型为 long(int64),为读取的数据长度,缺省值为全文件长度- 当长度大于 2^31 - 1 时,报错
- 当长度大于从 offset 起的剩余文件长度时,会取从 offset 起的文件内容
- length 小于 0 时,视为读取 offset 开始 object 剩下的所有数据
示例:
IoTDB:database1> select READ_OBJECT(s1) from table1 where device_id = 'tag1'
+------------+
|       _col0|
+------------+
|0x696f746462|
+------------+
Total line number = 1


IoTDB:database1> select READ_OBJECT(s1, 0, 3) from table1 where device_id = 'tag1'
+--------+
|   _col0|
+--------+
|0x696f74|
+--------+
Total line number = 1
6. read_tsfile 表值函数
6.1 功能概述
用于从外部 TsFile 文件或目录读取表模型数据。read_tsfile 返回一个临时表数据源,查询时可像普通表一样使用 SELECT、WHERE、ORDER BY、LIMIT、OFFSET、聚合等能力,对外部 TsFile 数据进行只读分析和临时处理,不会将处理结果写回外部 TsFile,也不会修改 IoTDB 内部数据,不支持通过该入口写入、删除、修改或注册外部 TsFile。
V2.0.12.1 版本起支持
6.2 函数定义
SELECT *
FROM TABLE(
  read_tsfile(
    TABLE_NAME => '<table_name>',
    PATHS => '<tsfile_or_directory_path>'
  )
);
6.3 参数说明
| 参数 | 必填 | 说明 |
|---|---|---|
PATHS | 是 | TsFile 文件路径或目录路径。单路径直接传入字符串;多路径在同一个字符串中使用英文逗号分隔,例如 '/data/a.tsfile,/data/b.tsfile,/data/history'。- 指定文件时,系统会直接尝试打开该文件; - 指定目录时,系统会递归遍历目录下以 .tsfile 为后缀的文件,并根据文件首尾的 MAGIC NUMBER 识别有效 TsFile。文件内容不符合 TsFile 格式、无法识别、不完整或版本不是 TsFile V4 的文件不参与本次查询。注意:指定的路径必须对执行查询的 DataNode 进程可见,并且 DataNode 进程需要具备相应的文件读取权限。禁止指定 DataNode 的任意数据目录,否则查询会报错。 |
TABLE_NAME | 否 | 需要读取的表名。填写该参数时,系统只读取包含目标表 Schema 的有效文件;如果所有有效文件中都不存在目标表 Schema,查询报错。 当外部 TsFile 中可以唯一推断出待读取的表名时,可以省略该参数;省略时要求每个参与读取的有效文件中都有且只有一个表,并且所有有效文件推断出的表名一致。如果某个有效文件包含多个表,或者不同有效文件中的唯一表名不一致,查询报错。 |
DEVICE_METADATA_INFO_SWAP_THRESHOLD | 否 | 查询时如果文件数和设备数量都很多,为了避免占用过多内存可能会将一些信息写成交换文件,这个参数可指定一个 Long 值,当达到此大小时强制触发交换临时文件,默认值为 8MB |
Schema 合并规则
读取多个 TsFile 时,系统会在确定目标表后,合并该表的 Schema,并将合并后的 Schema 作为本次查询的输出 Schema,且仅用于本次查询,不会注册到数据库元数据中。其合并规则如下:
tag 列按顺序合并。存在冲突时要求前缀一致;同一位置 tag 名称不同时报错;允许后续位置追加 tag 列。
time 列名称必须一致,存在冲突时报错。
field 列对顺序无要求,不同文件可以包含不同 field 列,系统会进行增量合并;同名 field 列的数据类型必须兼容,否则报错。
不同 TsFile 中同名列的列类型必须一致,否则报错。
返回结果
返回指定表的数据结果集。
输出列来自外部 TsFile 中目标表的合并 Schema。
time列为时间列,列名取决于 TsFile 中记录的时间列名称。tag 列表示设备标识信息。
field 列表示实际测点数据。
6.4 使用示例
假设在/data/backup/ 路径下有文件 1.tsfile, 该文件中的元数据和数据可参考 示例数据 中的 table1
- 自动推断表名读取 TsFile。
该场景要求 /data/backup/1.tsfile 中有且只有一个表。
SELECT *
FROM TABLE(
  read_tsfile(
    PATHS => '/data/backup/1.tsfile'
  )
)
LIMIT 10;
返回结果
+-----------------------------+------+--------+---------+--------+-----------+-----------+--------+------+-----------------------------+
|                         time|region|plant_id|device_id|model_id|maintenance|temperature|humidity|status|                 arrival_time|
+-----------------------------+------+--------+---------+--------+-----------+-----------+--------+------+-----------------------------+
|2024-11-29T10:00:00.000+08:00|  上海|    3001|      101|       D|        360|       85.0|    null|  null|2024-11-29T10:00:13.000+08:00|
|2024-11-29T11:00:00.000+08:00|  上海|    3002|      100|       E|        180|       null|    45.1|  true|                         null|
|2024-11-29T18:30:00.000+08:00|  上海|    3002|      100|       E|        180|       90.0|    35.4|  true|2024-11-29T18:30:15.000+08:00|
|2024-11-30T09:30:00.000+08:00|  上海|    3002|      101|       F|        360|       90.0|    35.2|  true|                         null|
|2024-11-30T14:30:00.000+08:00|  上海|    3002|      101|       F|        360|       90.0|    34.8|  true|2024-11-30T14:30:17.000+08:00|
|2024-11-26T13:37:00.000+08:00|  北京|    1001|      100|       A|        180|       90.0|    35.1|  true|2024-11-26T13:37:34.000+08:00|
|2024-11-26T13:38:00.000+08:00|  北京|    1001|      100|       A|        180|       90.0|    35.1|  true|2024-11-26T13:38:25.000+08:00|
|2024-11-28T08:00:00.000+08:00|  上海|    3001|      100|       C|         90|       85.0|    null|  null|2024-11-28T08:00:09.000+08:00|
|2024-11-28T09:00:00.000+08:00|  上海|    3001|      100|       C|         90|       null|    40.9|  true|                         null|
|2024-11-28T10:00:00.000+08:00|  上海|    3001|      100|       C|         90|       85.0|    35.2|  null|2024-11-28T10:00:11.000+08:00|
+-----------------------------+------+--------+---------+--------+-----------+-----------+--------+------+-----------------------------+
Total line number = 10
It costs 0.159s- 读取目录下的 TsFile。
SELECT time, device_id, temperature
FROM TABLE(
  read_tsfile(
    TABLE_NAME => 'table1',
    PATHS => '/data/backup'
  )
)
WHERE time >= 2024-11-28 00:00:00 AND time < 2024-11-29 00:00:00 ;
返回结果
+-----------------------------+---------+-----------+
|                         time|device_id|temperature|
+-----------------------------+---------+-----------+
|2024-11-28T08:00:00.000+08:00|      100|       85.0|
|2024-11-28T09:00:00.000+08:00|      100|       null|
|2024-11-28T10:00:00.000+08:00|      100|       85.0|
|2024-11-28T11:00:00.000+08:00|      100|       88.0|
+-----------------------------+---------+-----------+
Total line number = 4
It costs 0.116s- 按 tag 聚合。
SELECT device_id, count(temperature)
FROM TABLE(
  read_tsfile(
    TABLE_NAME => 'table1',
    PATHS => '/data/backup'
  )
)
GROUP BY device_id;
返回结果
+---------+-----+
|device_id|_col1|
+---------+-----+
|      100|    6|
|      101|    6|
+---------+-----+
Total line number = 2
It costs 0.049s
7. 时间序列趋势匹配表值函数
7.1 功能描述
pattern_match 表值函数支持基于输入的模式(pattern)序列,在指定的历史时间序列中,查找并返回所有符合阈值、结果边界等预设判定条件的子序列。
V2.0.12.1 版本起支持
7.2 函数定义
pattern_match(
  data => {table_name | subquery} PARTITION BY partition_col ORDER BY time_col,
  [time_col => 'time_column_name',]
  data_col => 'data_column_name',
  pattern => 'pattern_sequence',
  smooth => numeric_value,
  threshold => numeric_value,
  [width => numeric_value,]
  [height => numeric_value,]
  [smooth_on_pattern => {true | false}]
)
7.3 参数说明
| 参数 | 类型 | 必填 | 默认值 | 说明 |
|---|---|---|---|---|
data | 表名/子查询 | 是 | - | 时间序列所在的表名或子查询结果,必须保证时间列有序;支持 PARTITION BY 按字段分区、ORDER BY 按时间排序 |
time_col | 字符串 | 否 | 'time' | 时间列名称,仅支持时间戳类型 |
data_col | 字符串 | 是 | - | 序列名称,支持的数据类型:int、long、double、float |
pattern | 字符串 | 是 | - | 匹配模式序列,格式为数值列表(支持普通趋势序列 + 正则规则): 1. 基础格式:以逗号分隔的整型 / 浮点型数值(如 '1.0,2.0,3.0'); 2. 正则扩展:支持 {数值段}+(至少 1 次重复)、{数值段}*(至少 0 次重复),其中 {,}*,}+ 为独立单位;3. 特殊规则:每个段的最左侧点与上一个段共用 |
smooth | 非负实数 | 是 | 数据波动容忍幅度(平滑程度): 1. 数值越大,容忍的波动越大,但易过度平滑正常数据; 2. 推荐值:值域的 1%,可根据序列特性调整 | |
threshold | 非负实数 | 是 | 相似度阈值:仅返回相似度小于该值的结果,数值越小匹配越精确;建议从 1 开始向上调整 | |
width | 非负实数 | 否 | 无限大 | 匹配结果的宽度限制:仅返回长度(时间戳差值)小于该值的子序列 |
height | 非负实数 | 否 | 无限大 | 匹配结果的高度限制:仅返回高度小于该值的子序列 |
smooth_on_pattern | 布尔值 | 否 | false | 是否对 pattern 做平滑处理: 1. false:pattern 为形状趋势,仅对原始序列做平滑; 2. true:对 pattern 和原始序列做同等平滑降噪 |
返回结果
输出结果中仅保留与 pattern 匹配的数据段对应的行,且输出行按 match_index 升序排列。未匹配的行全部丢弃。
| 列名 | 类型 | 说明 |
|---|---|---|
match_index | int32 | 非负整数,表示匹配到的第 N 个符合 pattern 的数据段 |
similarity | double | 非负实数,表示该数据段与 pattern 的匹配相似度(值越小,匹配越精确) |
| data 参数所有列 | 与原列一致 | 包含输入 data 参数中所有列的原始数据 |
7.4 使用示例
以下示例演示普通模板匹配、参数调整、正则模板匹配以及平滑处理。
7.4.1 准备测试数据
创建表并写入数据:
create table test(value DOUBLE FIELD, value1 DOUBLE FIELD);
INSERT INTO test VALUES (1, 1, 0),(2, 2, 0),(3, 1, 0),(4, 1, 0),(5, 1, 0),(6, 1.2, 0),(7, 1, 0),(8, 1, 0),(9, 2, 0),(10, 3, 0),(11, 4, 0),(12, 3, 0),(13, 2, 0),(14, 3, 0),(15, 4, 0),(16, 2, 0),(17, 1, 0),(18, 1, 0),(19, 1, 0),(20, 1, 0),(21, 1, 0),(41, 1, 0),(42, 2, 0),(43, 3, 0),(44, 4, 0),(45, 3, 0),(46, 2, 0),(47, 2, 0),(48, 2, 0),(49, 2, 0),(50, 2, 0),(51, 2, 0),(52, 2, 0);
可通过如下语句查询数据:
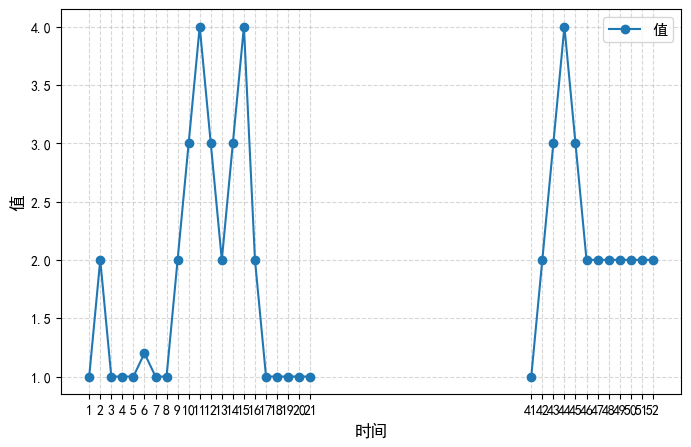
select * from test;图示效果如下:
7.4.2 基础趋势匹配
使用普通序列作为模板,查找数据中趋势相似的子序列。
select * from pattern_match(
  data => test ORDER BY time,
  time_col => 'time',
  data_col => 'value',
  pattern => '1.0,2.0,3.0,2.0,1.0,1.0,1.0,1.0,1.0',
  smooth => 0.5,
  threshold => 10.0,
  width => 1000.0,
  height => 500.0,
  smooth_on_pattern=> false
);
图示效果
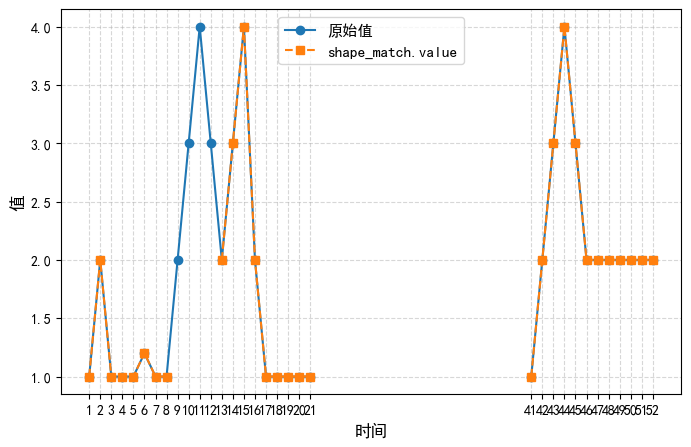
查询返回 3 组趋势匹配结果。相似度越小,表示匹配程度越高。
+-----------+------------------+-----------------------------+-----+------+
|match_index|        similarity|                         time|value|value1|
+-----------+------------------+-----------------------------+-----+------+
|          0| 4.637180787192477|1970-01-01T08:00:00.001+08:00|  1.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.002+08:00|  2.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.003+08:00|  1.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.004+08:00|  1.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.005+08:00|  1.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.006+08:00|  1.2|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.007+08:00|  1.0|   0.0|
|          0| 4.637180787192477|1970-01-01T08:00:00.008+08:00|  1.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.013+08:00|  2.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.014+08:00|  3.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.015+08:00|  4.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.016+08:00|  2.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.017+08:00|  1.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.018+08:00|  1.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.019+08:00|  1.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.020+08:00|  1.0|   0.0|
|          1|0.6465473220616865|1970-01-01T08:00:00.021+08:00|  1.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.041+08:00|  1.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.042+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.043+08:00|  3.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.044+08:00|  4.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.045+08:00|  3.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.046+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.047+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.048+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.049+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.050+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.051+08:00|  2.0|   0.0|
|          2| 0.679768727042932|1970-01-01T08:00:00.052+08:00|  2.0|   0.0|
+-----------+------------------+-----------------------------+-----+------+
Total line number = 29
It costs 0.126s
7.4.3 调整匹配条件
以下示例均以 7.4.2 的基础查询为准,仅修改对应参数。
| 调整目的 | 参数 | 基础值 | 调整值 | 调整效果 |
|---|---|---|---|---|
| 提高匹配精度 | threshold | 10.0 | 1.0 | 仅保留相似度小于 1.0 的结果,匹配结果由 3 组减少为 2 组 |
| 限制匹配时间跨度 | width | 1000.0 | 10.0 | 仅返回时间跨度小于 10.0 的子序列 |
| 限制数值波动范围 | height | 500.0 | 2.0 | 仅返回数值波动范围小于 2.0 的子序列 |
7.4.4 正则模板匹配
正则模板可以用于匹配重复出现的趋势片段。
| 重复符号 | 含义 |
|---|---|
+ | 前面的子序列至少出现 1 次 |
* | 前面的子序列可以出现 0 次或多次 |
以下示例使用 + 匹配至少出现一次的子序列 2.0,3.0,2.0:
select * from pattern_match(
  data              => test ORDER BY time,
  time_col          => 'time',
  data_col          => 'value',
  pattern           => '1.0,{2.0,3.0,2.0}+,1.0,1.0,1.0,1.0,1.0',
  smooth            => 0.5,
  threshold         => 100.0,
  width             => 1000.0,
  height            => 500.0,
  smooth_on_pattern => false
);
如果允许子序列 2.0,3.0,2.0 出现零次或多次,可以将 + 修改为 *:
pattern => '1.0,{2.0,3.0,2.0}*,1.0,1.0,1.0,1.0,1.0'正则模板适用于周期性波动、重复峰值以及长度不固定的趋势匹配场景。
7.4.5 模板平滑处理
当模板序列包含小幅波动时,可以通过 smooth_on_pattern 控制是否对模板序列进行平滑处理。
以下示例展示两种不同参数配置下的匹配结果:
| 配置 | threshold | smooth_on_pattern | 匹配效果 |
|---|---|---|---|
| 同时平滑原始序列和模板序列 | 1.0 | true | 可以匹配原始数据中的 1.0,1.2,1.0 波动片段 |
| 仅平滑原始序列 | 10.0 | false | 仍可返回其他趋势匹配结果,但不包含对应的 1.0,1.2,1.0 波动片段 |
同时平滑原始序列和模板序列:
SELECT *
FROM pattern_match(
  data              => test ORDER BY time,
  time_col          => 'time',
  data_col          => 'value',
  pattern           => '1.0,1.2,1.0',
  smooth            => 0.5,
  threshold         => 1.0,
  width             => 1000.0,
  height            => 500.0,
  smooth_on_pattern => true
);
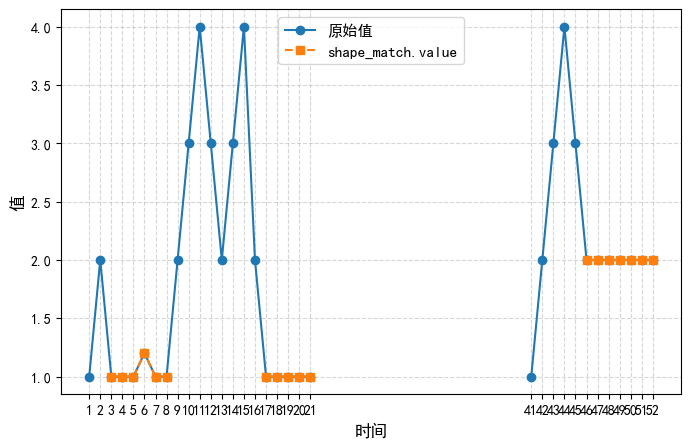
在该配置下,原始序列和模板序列采用相同的平滑规则,可以匹配包含时间点 5、6、7 对应的 1.0,1.2,1.0 波动片段。
图示效果如下:
仅平滑原始序列:
SELECT *
FROM pattern_match(
  data              => test ORDER BY time,
  time_col          => 'time',
  data_col          => 'value',
  pattern           => '1.0,1.2,1.0',
  smooth            => 0.5,
  threshold         => 10.0,
  width             => 1000.0,
  height            => 500.0,
  smooth_on_pattern => false
);
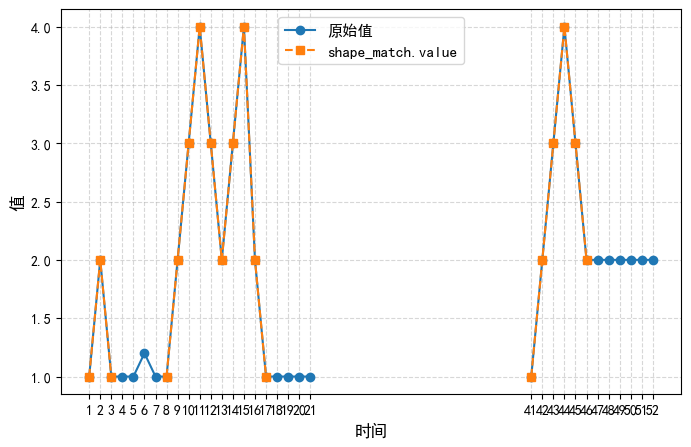
在该配置下,仅对原始序列进行平滑处理。查询仍可返回其他趋势匹配结果,但时间点 5、6、7 对应的 1.0,1.2,1.0 波动片段未被匹配。
图示效果如下:
8. 频域分析函数
8.1 FFT
8.1.1 功能概述
表模型内置表值函数 FFT 用于对输入表各分区内的一个或多个实值数值序列执行一维快速傅里叶变换。输入数据必须通过 ORDER BY 指定时间列并按升序排列,也可通过 PARTITION BY 按设备或 Tag 进行分组。每个分区独立生成一组频率 bin,同一分区内的多个数值列共享该频率轴。
V2.0.12.1 版本起支持
8.1.2 函数定义
- 命名参数语法如下:
SELECT *
FROM FFT(
  DATA => {table_name | subquery}
    [PARTITION BY partition_column [, ...]]
    ORDER BY time_column,
  [SAMPLE_INTERVAL => duration_literal,]
  [N => positive_integer,]
  [NORM => {'backward' | 'forward' | 'ortho'},]
  [TIMECOL => 'time_column']
);- 位置参数语法如下:
SELECT *
FROM TABLE(
  FFT(
    TABLE(table_name)
      [PARTITION BY partition_column [, ...]]
      ORDER BY time_column
    [, duration_literal
    [, positive_integer
    [, norm
    [, time_column_name]]]]
  )
);
参数的规范顺序为 DATA, SAMPLE_INTERVAL, N, NORM, TIMECOL。推荐使用命名参数,以提高复杂调用的可读性。
8.1.3 参数说明
| 参数 | 是否必填 | 类型 | 默认值 | 说明 |
|---|---|---|---|---|
DATA | 是 | 表参数 | 无 | 指定 FFT 的输入数据。可以使用 PARTITION BY 分区,每个分区独立计算;省略时,全部数据作为一个分区。除时间列和分区列外,所有 INT32、INT64、FLOAT 和 DOUBLE 列均参与计算,其他类型的列自动忽略。输入中至少需要一个数值列,且参与计算的列不能包含 NULL。如需只计算部分数值列,可在输入子查询中提前选择。 |
SAMPLE_INTERVAL | 否 | 正数时间间隔字面量 | 根据时间列推断 | 指定采样间隔,例如 1ms、10ms 或 1s,用于计算频率轴。未指定时,每个分区按照 (最后一个时间戳 - 第一个时间戳) / (输入行数 - 1) 推断。单行分区无法自动推断,必须显式指定;空分区直接返回 0 行。 |
N | 否 | 正整数 | 当前分区的输入行数 | 指定 FFT 变换长度。小于输入行数时,使用按时间排序后的前 N 行;大于输入行数时,在序列尾部补 0。每个分区输出 N 行结果。N 最大为 65536,且需满足 N × 2 × 参与计算的数值列数 ≤ 16777216。 |
NORM | 否 | 字符串 | backward | 指定 FFT 结果的归一化方式,大小写不敏感。backward:不进行归一化;forward:将结果除以变换长度 N;ortho:将结果除以 √N。 |
TIMECOL | 否 | 字符串 | time | 指定时间列名称,对应列必须为 TIMESTAMP 类型。DATA 必须仅按照该列升序排列,不支持 DESC;每个分区内的时间戳必须严格递增,不允许重复。 |
FFT 通常适用于等间隔采样的数据。本函数不会自动检测或修正不等间隔的数据。为确保频谱结果准确,请在计算前对数据进行插值或重采样;如果采样间隔已知,建议通过
SAMPLE_INTERVAL显式指定。当
N小于输入行数时,函数仍会检查分区内的全部输入数据,但只使用前N行进行 FFT 计算。
返回结果
FFT 返回每个分区的完整双边频谱,输出列顺序如下:
分区列...
frequency_index
frequency
<数值列名>_real
<数值列名>_imag
...| 输出列 | 类型 | 说明 |
|---|---|---|
PARTITION BY 指定的列 | 与输入类型一致 | 保留原列名和类型,位于结果集最前面。未使用 PARTITION BY 时不输出。 |
frequency_index | INT64 | 频率点索引,范围为 0 至 N-1。 |
frequency | DOUBLE | 当前频率点对应的频率,单位为 Hz。 |
<数值列名>_real | DOUBLE | 对应输入数值列的 FFT 实部。 |
<数值列名>_imag | DOUBLE | 对应输入数值列的 FFT 虚部。 |
对于变换长度 N 和采样间隔 d(单位为秒),frequency 的计算方式如下:
| frequency_index 范围 | frequency |
|---|---|
frequency_index < ceil(N / 2) | frequency_index / (N × d) |
| 其他情况 | (frequency_index - N) / (N × d) |
频率按照零频率、正频率、负频率的顺序排列,单位为 Hz。同一分区内,所有数值列共享相同的频率轴。
8.1.4 注意事项
FFT函数名不区分大小写。每个分区独立执行一维 FFT。当前版本仅支持实数输入,不支持复数输入、
DFT或IFFT。当前版本仅输出完整频谱的实部和虚部,不支持单边频谱、振幅或相位输出。
当前版本不支持
VALUE、SAMPLE_RATE和SPECTRUM参数。
8.1.5 使用示例
以下示例直接使用 table1 中的数据。由于 temperature 包含 NULL,需要在输入子查询中提前过滤。
- 示例 1:按设备执行 FFT
SELECT *
FROM FFT(
  DATA => (
    SELECT time, device_id, temperature
    FROM table1
    WHERE plant_id = '1001'
      AND temperature IS NOT NULL
  ) PARTITION BY device_id ORDER BY time
)
ORDER BY device_id, frequency_index;
函数分别对每个设备的 temperature 执行 FFT。未指定 N 和 SAMPLE_INTERVAL 时,函数根据各分区的输入行数确定变换长度,并根据时间列推断采样间隔。本例中的采样间隔为 1 分钟。
+---------+---------------+---------------------+----------------------+---------------------+
|device_id|frequency_index|            frequency|      temperature_real|     temperature_imag|
+---------+---------------+---------------------+----------------------+---------------------+
|      100|              0|                  0.0|                 180.0|                  0.0|
|      100|              1|-0.008333333333333333|                   0.0|                  0.0|
|      101|              0|                  0.0|                 255.0| -6.67572021484375E-6|
|      101|              1| 0.005555555555555556|-4.6126147026370745E-6|-5.266308107820805E-6|
|      101|              2|-0.005555555555555556|   -1.9073486328125E-6| 3.303624680484063E-6|
+---------+---------------+---------------------+----------------------+---------------------+- 示例 2:指定变换长度和归一化方式
SELECT *
FROM FFT(
  DATA => (
    SELECT time, device_id, temperature
    FROM table1
    WHERE plant_id = '1001'
      AND temperature IS NOT NULL
  ) PARTITION BY device_id ORDER BY time,
  SAMPLE_INTERVAL => 1m,
  N => 4,
  NORM => 'ortho'
)
ORDER BY device_id, frequency_index;
函数将每个设备的变换长度设置为 4。输入数据不足 4 行时,在数值序列尾部补 0;FFT 结果按照 1/√N 进行归一化。每个设备均返回 4 行频谱结果。
+---------+---------------+---------------------+----------------------+----------------+
|device_id|frequency_index|            frequency|      temperature_real|temperature_imag|
+---------+---------------+---------------------+----------------------+----------------+
|      100|              0|                  0.0|                  90.0|             0.0|
|      100|              1| 0.004166666666666667|                  45.0|           -45.0|
|      100|              2|-0.008333333333333333|                   0.0|             0.0|
|      100|              3|-0.004166666666666667|                  45.0|            45.0|
|      101|              0|                  0.0|                 127.5|             0.0|
|      101|              1| 0.004166666666666667| 2.602374475716698E-15|           -42.5|
|      101|              2|-0.008333333333333333|                  42.5|             0.0|
|      101|              3|-0.004166666666666667|-2.602374475716698E-15|            42.5|
+---------+---------------+---------------------+----------------------+----------------+- 示例 3:数值列包含
NULL
SELECT *
FROM FFT(
  DATA => (
    SELECT time, device_id, temperature
    FROM table1
    WHERE plant_id = '1001'
  ) PARTITION BY device_id ORDER BY time
);
由于参与 FFT 计算的数值列不能包含 NULL,查询执行失败:
Msg: org.apache.iotdb.jdbc.IoTDBSQLException: 701: FFT does not support null values in column [temperature].可以在输入子查询中使用 IS NOT NULL 过滤空值后再执行 FFT。
8.2 lowPass
8.2.1 功能描述
lowPass 是低通滤波函数,对输入表中的数值列执行频域滤波,保留低频成分并衰减高频成分,适用于信号平滑和高频噪声去除。参数 wpass 为归一化通带频率,取值范围为 (0, 1),用于指定允许通过的频率上限。
V2.0.12.1 版本起支持
8.2.2 函数定义
- 命名参数语法如下:
SELECT *
FROM lowPass(
  DATA => input_table PARTITION BY partition_column ORDER BY time_column,
  TIMECOL => 'time_column',
  WPASS => passband_frequency
);- 位置参数语法如下:
SELECT *
FROM lowPass(
  input_table PARTITION BY partition_column ORDER BY time_column,
  'time_column',
  passband_frequency
);
8.2.3 参数说明
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
DATA | 表参数(SET SEMANTIC) | 是 | 输入表或子查询。ORDER BY 必须仅指定时间列并按升序排列;PARTITION BY 可选,不指定时整张表作为一个分区。 |
TIMECOL | 字符串 | 是 | 时间列名称,必须为时间戳类型,且只能指定一个时间列。 |
WPASS | DOUBLE | 是 | 归一化通带频率,取值范围为 (0, 1);低于该频率的成分保留,高于该频率的成分衰减。 |
计算规则
TIMECOL和PARTITION BY指定的列不参与计算,但会保留在输出中。除时间列和分区列外,仅
INT32、INT64、FLOAT、DOUBLE列参与计算;不存在可计算列或存在其他类型列时,分析阶段报错。参与计算列中的
NULL值不参与该列的滤波计算。
返回结果
输出分区列(如指定)和时间列,列名及类型保持不变。
每个参与计算的数值列输出一个滤波结果列,类型统一为
DOUBLE。每个结果列的测点数与对应输入列一致,结果按时间戳升序输出。
8.2.4 使用示例
以下示例直接使用 table1 中的数据。
SELECT *
FROM lowPass(
  DATA => (
     SELECT time, device_id, temperature
     FROM table1
     WHERE temperature is not null
  ) PARTITION BY device_id  ORDER BY time,
  TIMECOL => 'time',
  WPASS => 0.3
);
该示例按设备分区,对 temperature 列执行低通滤波,输出 device_id、time 以及滤波后的数值列。
+---------+-----------------------------+--------------------+
|device_id|                         time|lowpass(temperature)|
+---------+-----------------------------+--------------------+
|      100|2024-11-26T13:37:00.000+08:00|                88.0|
|      100|2024-11-26T13:38:00.000+08:00|                88.0|
|      100|2024-11-28T08:00:00.000+08:00|   87.99999999999999|
|      100|2024-11-28T10:00:00.000+08:00|   87.99999999999999|
|      100|2024-11-28T11:00:00.000+08:00|   88.00000000000001|
|      100|2024-11-29T18:30:00.000+08:00|                88.0|
|      101|2024-11-27T16:39:00.000+08:00|   86.66666666666667|
|      101|2024-11-27T16:40:00.000+08:00|   86.66666666666667|
|      101|2024-11-27T16:41:00.000+08:00|   86.66666666666664|
|      101|2024-11-29T10:00:00.000+08:00|   86.66666666666664|
|      101|2024-11-30T09:30:00.000+08:00|   86.66666666666667|
|      101|2024-11-30T14:30:00.000+08:00|   86.66666666666664|
+---------+-----------------------------+--------------------+
8.3 highPass
8.3.1 功能描述
highPass 是高通滤波函数,对输入表中的数值列执行频域滤波,保留高频成分并衰减低频成分,适用于提取快速变化、跳变和高频噪声等信号成分。参数 wpass 为归一化通带频率,取值范围为 (0, 1),用于指定允许通过的频率下限。
V2.0.12.1 版本起支持
8.3.2 函数定义
- 命名参数语法如下:
SELECT *
FROM highPass(
  DATA => input_table PARTITION BY partition_column ORDER BY time_column,
  TIMECOL => 'time_column',
  WPASS => passband_frequency
);- 位置参数语法如下:
SELECT *
FROM highPass(
  input_table PARTITION BY partition_column ORDER BY time_column,
  'time_column',
  passband_frequency
);
8.3.3 参数说明
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
DATA | 表参数(SET SEMANTIC) | 是 | 输入表或子查询。ORDER BY 必须仅指定时间列并按升序排列;PARTITION BY 可选,不指定时整张表作为一个分区。 |
TIMECOL | 字符串 | 是 | 时间列名称,必须为时间戳类型,且只能指定一个时间列。 |
WPASS | DOUBLE | 是 | 归一化通带频率,取值范围为 (0, 1);高于该频率的成分保留,低于该频率的成分衰减。 |
输入列和计算规则
TIMECOL和PARTITION BY指定的列不参与计算,但会保留在输出中。除时间列和分区列外,仅
INT32、INT64、FLOAT、DOUBLE列参与计算;不存在可计算列或存在其他类型列时,分析阶段报错。参与计算列中的
NULL值不参与该列的滤波计算。
返回结果
输出分区列(如指定)和时间列,列名及类型保持不变。
每个参与计算的数值列输出一个滤波结果列,类型统一为
DOUBLE。每个结果列的测点数与对应输入列一致,结果按时间戳升序输出。
8.3.4 使用示例
SELECT *
FROM highPass(
  DATA => (
     SELECT time, device_id, temperature
     FROM table1
     WHERE temperature is not null
  ) PARTITION BY device_id  ORDER BY time,
  TIMECOL => 'time',
  WPASS => 0.3
);
该示例按设备分区,对 temperature 列执行高通滤波,输出 device_id、time 以及滤波后的数值列。
+---------+-----------------------------+----------------------+
|device_id|                         time| highpass(temperature)|
+---------+-----------------------------+----------------------+
|      100|2024-11-26T13:37:00.000+08:00|     2.000000000000029|
|      100|2024-11-26T13:38:00.000+08:00|     2.000000000000004|
|      100|2024-11-28T08:00:00.000+08:00|   -2.9999999999999702|
|      100|2024-11-28T10:00:00.000+08:00|    -3.000000000000013|
|      100|2024-11-28T11:00:00.000+08:00|-4.182831670630972E-14|
|      100|2024-11-29T18:30:00.000+08:00|    1.9999999999999953|
|      101|2024-11-27T16:39:00.000+08:00|    -1.666666666666642|
|      101|2024-11-27T16:40:00.000+08:00|   -1.6666666666666519|
|      101|2024-11-27T16:41:00.000+08:00|    -1.666666666666645|
|      101|2024-11-29T10:00:00.000+08:00|    -1.666666666666701|
|      101|2024-11-30T09:30:00.000+08:00|    3.3333333333333015|
|      101|2024-11-30T14:30:00.000+08:00|     3.333333333333338|
+---------+-----------------------------+----------------------+
9. 时序相关性分析函数
9.1 Xcorr
9.1.1 功能描述
Xcorr 是相关性分析函数,对输入的两列数值序列进行互相关分析,度量两条序列在不同时间滞后(lag)下的形状相似度。函数将一条序列逐步平移,与另一条序列逐点相乘并求和,输出相似度曲线,可用于发现两路信号之间的延迟关系和相似模式。
V2.0.12.1 版本起支持
9.1.2 函数定义
- 命名参数语法如下:
SELECT *
FROM Xcorr(
  DATA => (
    SELECT time_column, signal_1, signal_2, partition_column
    FROM input_table
  ) PARTITION BY partition_column ORDER BY time_column,
  TIMECOL => 'time_column'
);- 位置参数语法如下:
SELECT *
FROM Xcorr(
    ( SELECT time_column, signal_1, signal_2, partition_column
      FROM input_table
    ) PARTITION BY partition_column ORDER BY time_column,
    'time_column'
);
9.1.3 参数说明
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
DATA | 表参数(SET SEMANTIC) | 是 | 输入表或子查询。ORDER BY 必须指定时间列并按升序排列;PARTITION BY 可选。去除时间列和分区列后,必须恰好剩余两列数值列。 |
TIMECOL | 字符串 | 是 | 时间列名称,必须为时间戳类型,且只能指定一个时间列。 |
计算规则
时间列和分区列不参与互相关计算。
去除上述列后,必须恰好存在两列,且两列类型均为
INT32、INT64、FLOAT或DOUBLE;否则分析阶段报错。参与计算的两列中出现
NULL时,该位置按0参与计算。每个分区内时间列必须严格升序。
计算时按函数定义进行归一化处理。
返回结果
输出
PARTITION BY指定的分区列(如指定),列名及类型保持不变。对参与计算的两列,生成一个结果列,类型为double。
9.1.4 使用示例
以下示例使用 SQL 手册示例数据中的 table1,并通过子查询投影两列数值序列 temperature 和 humidity 参与互相关计算。
SELECT *
FROM Xcorr(
  DATA => (
    SELECT time, device_id, temperature, humidity
    FROM table1
    WHERE temperature IS NOT NULL
      AND humidity IS NOT NULL
  )
  PARTITION BY device_id
  ORDER BY time,
  TIMECOL => 'time'
);
该示例按设备分区,对 temperature 和 humidity 两列进行互相关分析,输出 device_id 以及相关性分析结果列。
+---------+----------------------------+
|device_id|xcorr(temperature, humidity)|
+---------+----------------------------+
|      100|          3186.0001373291016|
|      100|                      3622.5|
|      100|          3412.0000203450522|
|      100|          3318.9249839782715|
|      100|          3292.9599586486815|
|      100|          3324.7749156951904|
|      100|          3080.0999348958335|
|      100|          3123.8998641967773|
|      100|          3158.9998626708984|
|      101|          2957.9999351501465|
|      101|          3061.9999980926514|
|      101|           3100.166645050049|
|      101|                      3172.5|
|      101|           3176.999931335449|
+---------+----------------------------+